Existe una enorme literatura advirtiendo sobre los problemas del AUC como instrumento para comparar modelos. La combinación de los dos siguientes hechos empíricos impide que sea efectiva:
- El AUC es una medida simple cuya aplicación solo exige conocimientos básicos de aritmética: saber identificar el mayor de entre dos números. Las habilidades matemáticas de muchos de quienes lo utilizan para comparar modelos tampoco dan para mucho más.
- La literatura plantea argumentos que tienen, como en Measuring Classifier Performance: A Coherent Alternative to the Area Under the ROC curve, esta esotérica forma:
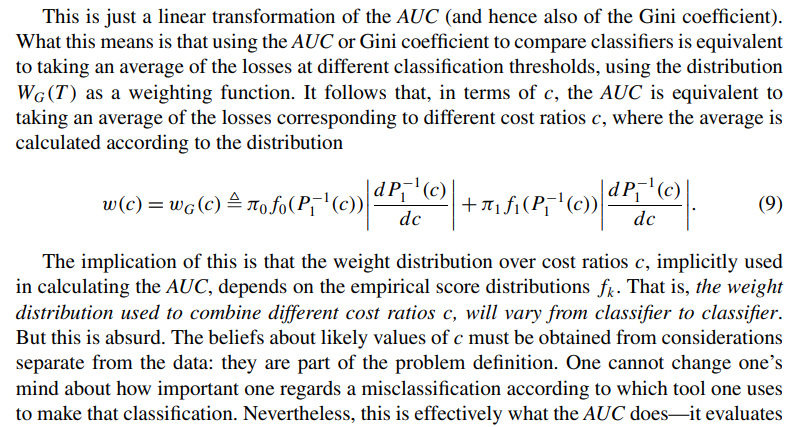
Como resultado, la gente, incluido el autor de estas líneas, avisa sobre los peligros del AUC pero nunca pasa nada.
Así las cosas, lo que escribo hoy tiene otro planteamiento y público objetivo.
El planteamiento es que si el AUC es inadecuado, tiene que haber una manera de explotarlo en tu beneficio (¡y la hay!). Y el público objetivo es gente que se encuentra con el siguiente problema: existe un modelo $M_0$ con un AUC del, digamos, 0.76 y quiere que alguien con capacidad de decisión de esos que solo prestan atención al AUC prefiera otro modelo $M_1$ por algún motivo e independientemente de su calidad, bondad, aplicabilidad, etc. con respecto a $M_0$. Es decir, que necesita asociar a $M_1$ un AUC mayor que 0.76.
Eso no es difícil.
De todas las interpretaciones del AUC, la más conveniente para la discusión de hoy es que mide el grado de solapamiento entre las distribuciones de probabilidad de los scores de los casos positivos (ones) y negativos (zeros). La siguiente figura muestra una configuración típica:
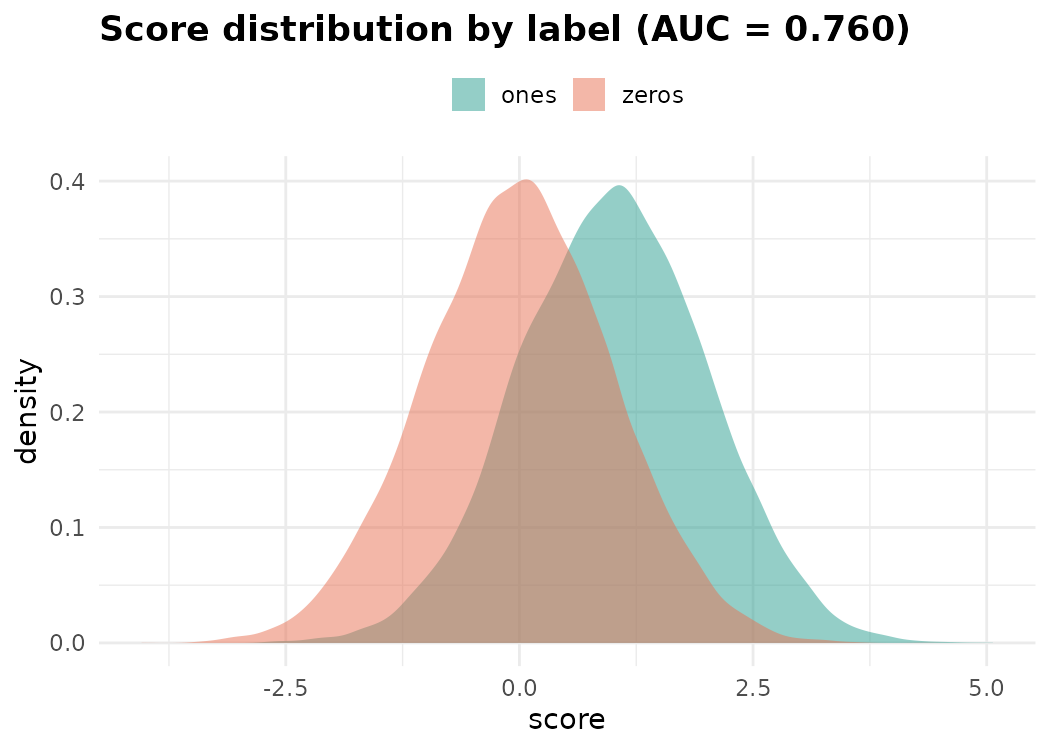
Una manera de reducir el solapamiento es escorar la distribución de los casos negativos hacia la izquierda (aunque también podría hacerse lo que es innecesario mencionar a la derecha o, incluso, una mezcla de ambas estrategias). Partiendo de los datos del ejemplo anterior, si se puede justificar la inclusión de casos adicionales de ceros con scores muy bajos (en este caso, un grupo de observaciones negativas con scores alrededor de -2.5), entonces se obtiene una configuración con un grado de solapamiento significativamente menor y, por lo tanto, un AUC mayor (.83 vs el .76 original).
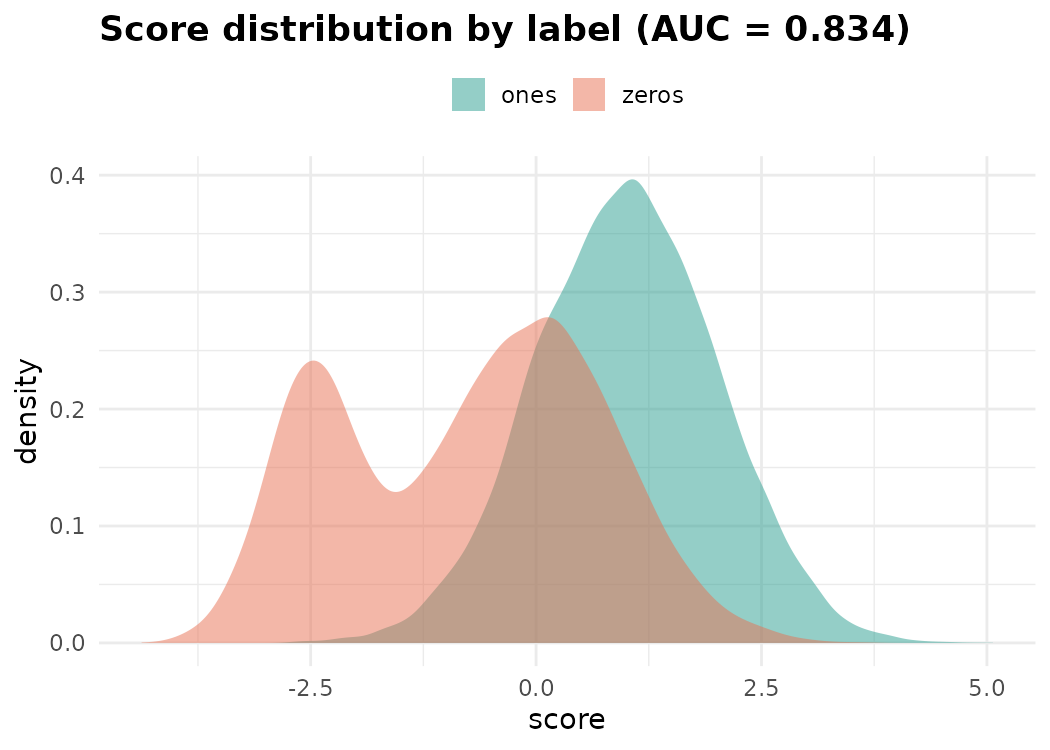
En este párrafo voy a presentar un ejemplo concreto inspirado en el artículo AUC: a misleading measure of the performance of predictive distribution models (en el que se discute —aunque en otros términos— la estrategia anterior). Supóngase que se construye un modelo para predecir la presencia del urogallo en distintos ecosistemas (sí, hay gente a la que pagan por esas cosas). Para ello se toma un mapa, se subdivide en pequeñas regiones que se marcan según se hayan o no avistado urogallos en ellas. Luego se crea un modelo predictivo en función de las características ecológicas de las distintas zonas. Un modelo $M_0$ podría tomar en cuenta la zona de los Picos de Europa y sus derredores y anunciar un AUC determinado. Un modelo no necesariamente mejor pero basado en un mapa que abarcase zonas del mar Cantábrico (nótese que el urogallo es un ave y no un pez) o de Usera tendría un AUC sustancialmente mayor: incluye regiones que son casos negativos con scores necesariamente bajísimos.
El problema para la implementación del programa anterior es la justificación del proceso de selección de la muestra interesada. Pero en un mundo en el que ya nadie aprende a escribir y nos hemos ido olvidando de cómo leer, no tiene por qué ser muy complicado.