La verdad, sé menos de eso que cualquier otro. Solo he visto
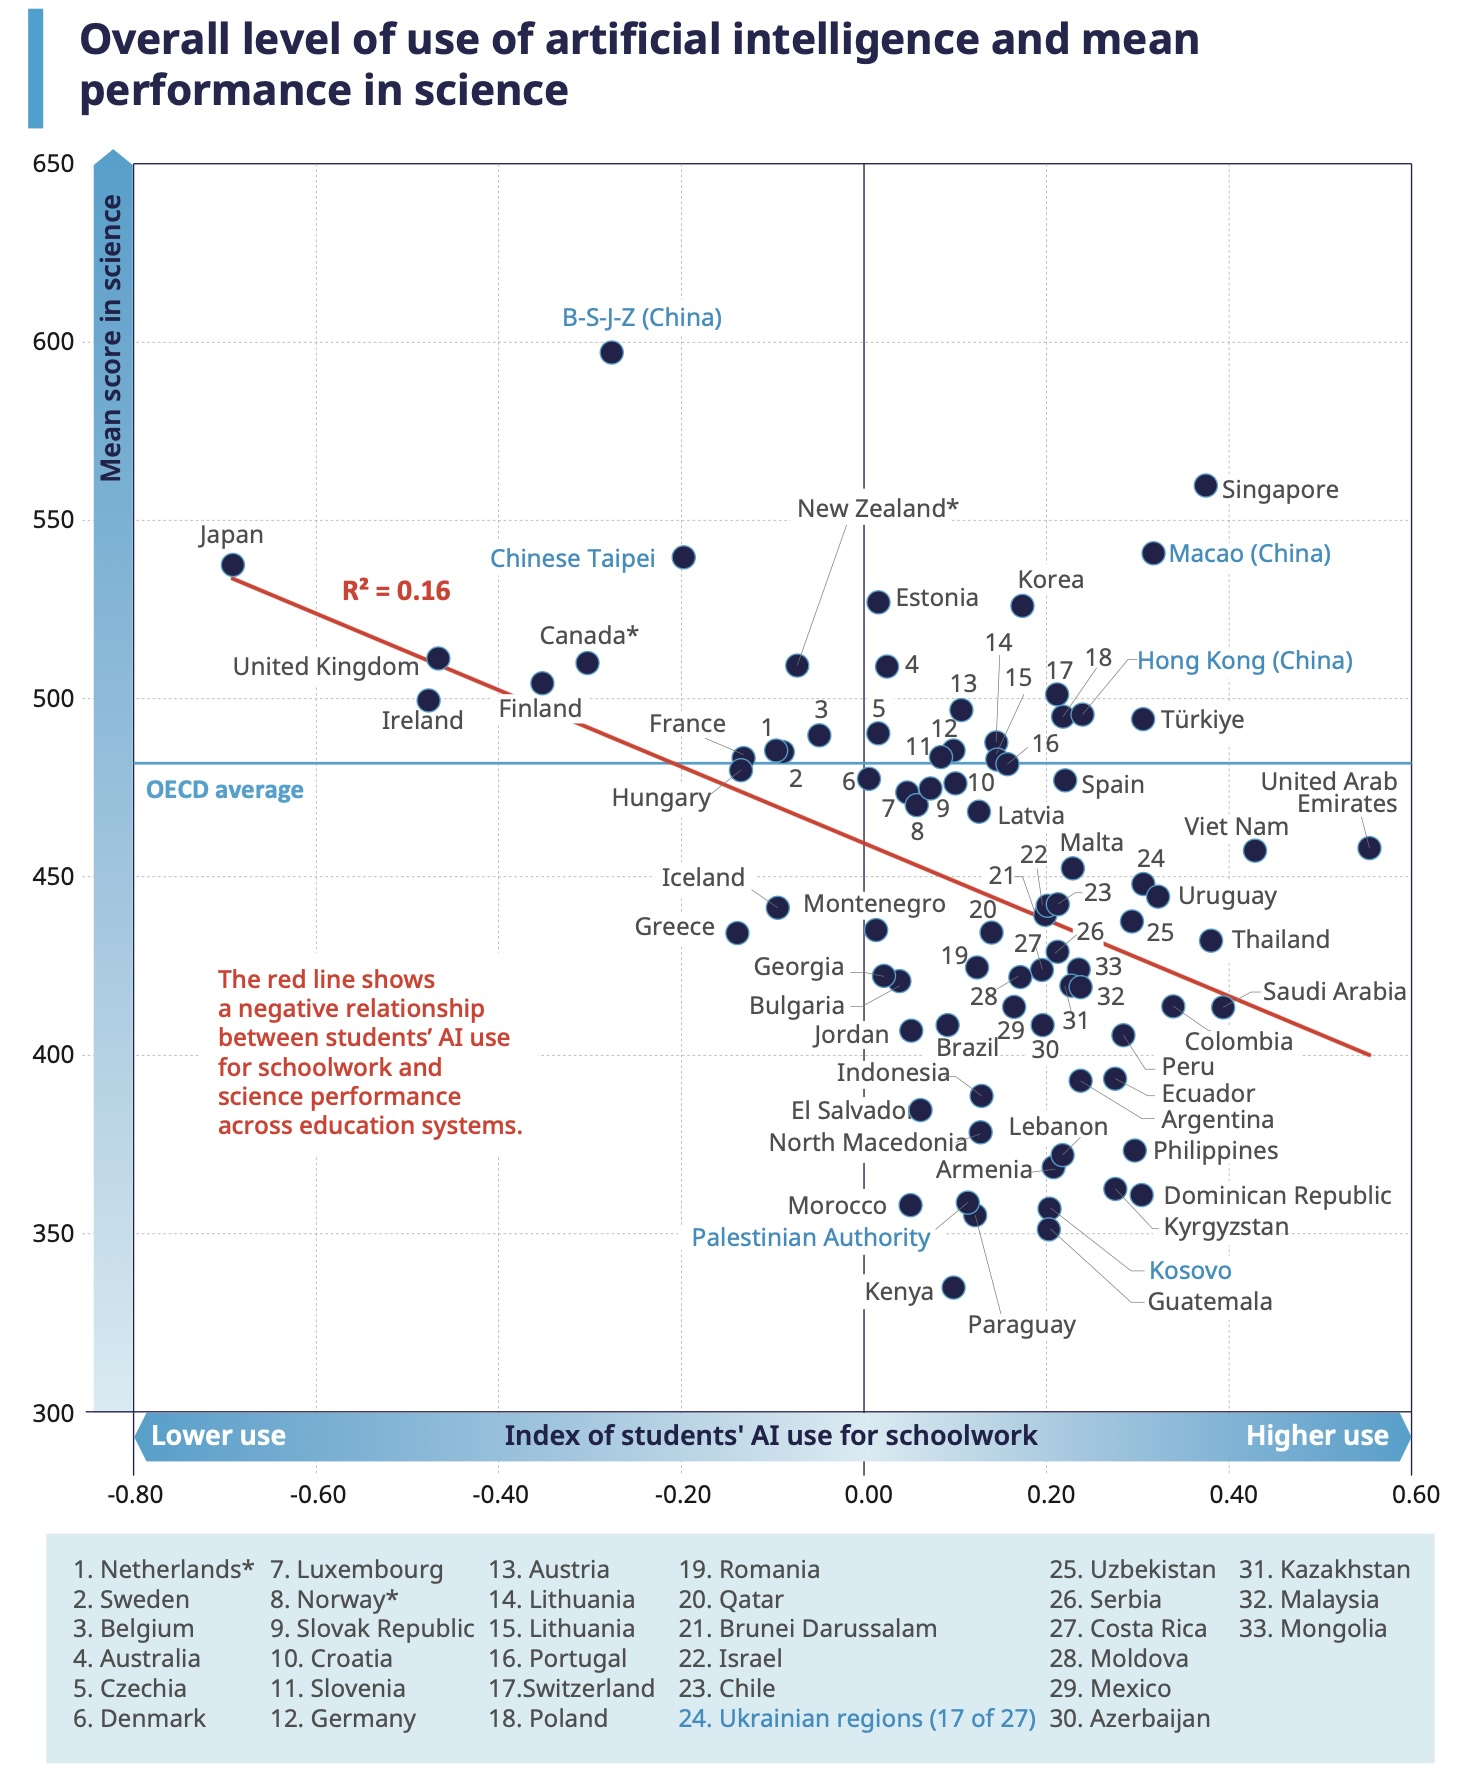
(supongo que procrastinando en Twitter) y me ha parecido conveniente razonar sobre él desde una perspectiva metodológica.
Vaya por delante que no he dedicado tiempo a trazar el origen de los datos y su pertinencia. Tampoco de repasar la narrativa que acompaña al gráfico en su fuente. Voy a asumir en lo que sigue que la información es razonablemente correcta y que quienquiera que construyó el gráfico pretendía señalar algún tipo de relación dentro del «espectro causal» entre los resultados de PISA y el uso de la IA.
Como punto de partida, les he pedido a dos LLMs que «colaboren adversariamente» para transformar los punticos en una tabla y luego he reproducido la regresión:
Call:
lm(formula = science_score ~ ai_use_index, data = d)

Residuals:
     Min       1Q   Median       3Q      Max
-108.081  -36.893    7.381   31.010  134.354

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept)   455.807      6.234  73.113  < 2e-16 ***
ai_use_index  -90.860     26.903  -3.377  0.00114 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 51.98 on 79 degrees of freedom
Multiple R-squared:  0.1262,	Adjusted R-squared:  0.1151
F-statistic: 11.41 on 1 and 79 DF,  p-value: 0.001138
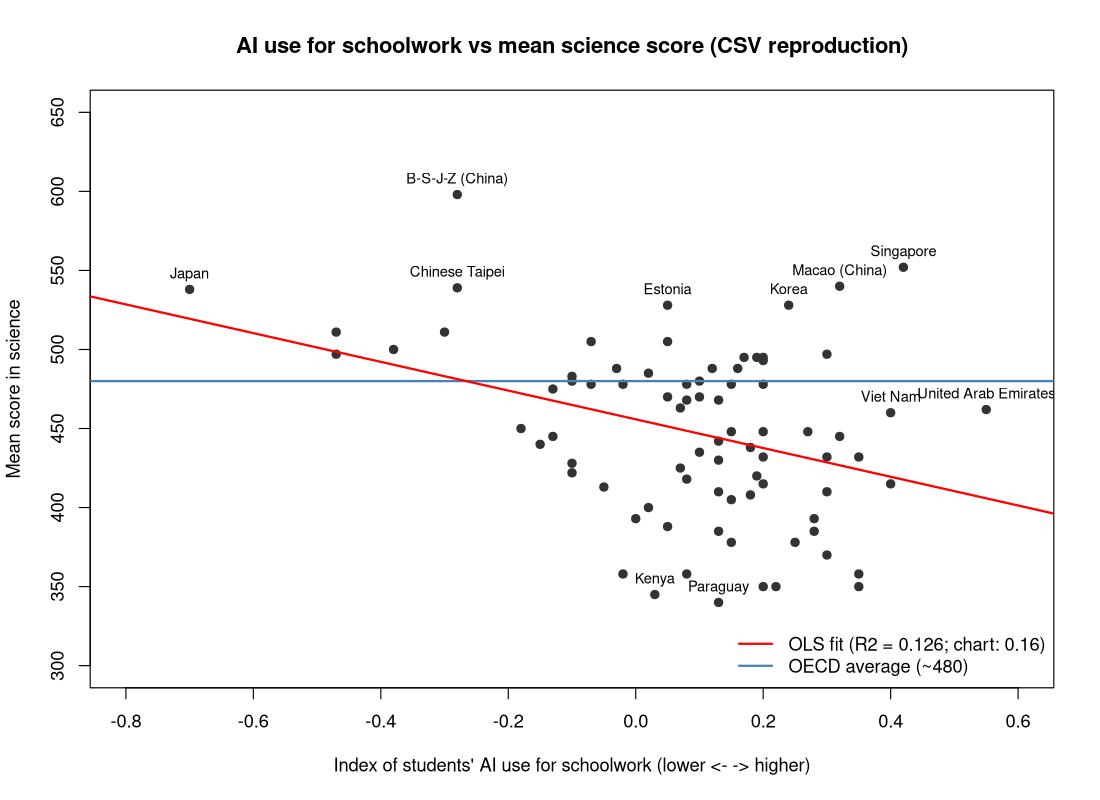
El coeficiente es altamente significativo, etc. Da para construir un argumento previsible.
No se obtiene el mismo resultado exactamente (la $R^2$ original es 0.16 y en la reproducción es de 0.12), pero voy a darla por buena; las discrepancias parecen deberse principalmente al ruido en la zona en la que se arraciman los resultados de muchos países. Estoy seguro de que en la cadena de operaciones que nos ha traído hasta este punto, este no es el eslabón más débil (y sí, estoy pensando, entre otras cosas, en la falacia ecológica).
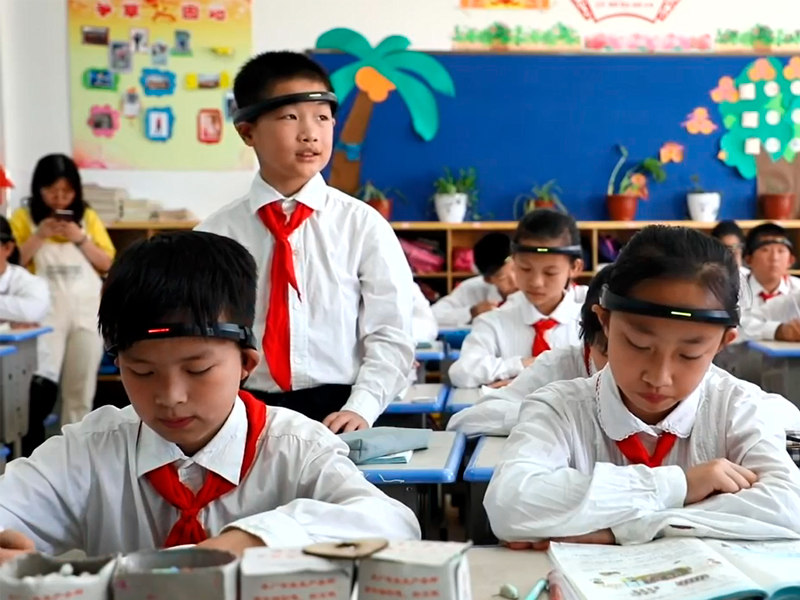
Pero si uno mira la «nube de datos» con atención, observará que es la superposición de tres aproximadamente «horizontales»: la de los países como
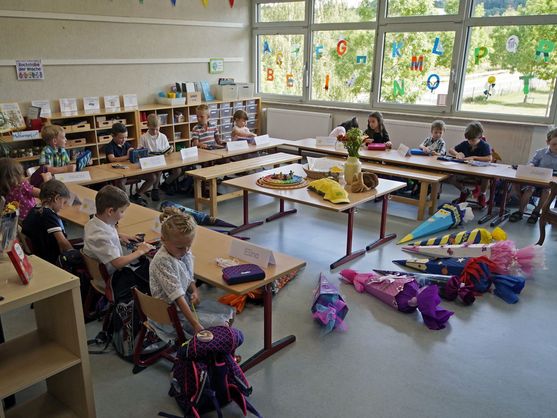
la de los países WEIRD, como
y, finalmente, la masa de países como
Las correspondientes regresiones por grupo dan:
Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept)    541.19      12.22  44.276 1.11e-07 ***
ai_use_index   -20.82      31.97  -0.651    0.544
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 32.32 on 5 degrees of freedom
Multiple R-squared:  0.0782,	Adjusted R-squared:  -0.1062
F-statistic: 0.4242 on 1 and 5 DF,  p-value: 0.5436
para el este de Asia,
Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept)   481.755      3.435 140.254   <2e-16 ***
ai_use_index  -29.191     18.429  -1.584    0.124
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 19.42 on 30 degrees of freedom
Multiple R-squared:  0.07718,	Adjusted R-squared:  0.04641
F-statistic: 2.509 on 1 and 30 DF,  p-value: 0.1237
para los WEIRD y
Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept)    399.88       8.77  45.597   <2e-16 ***
ai_use_index    36.85      38.19   0.965     0.34
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 36.8 on 40 degrees of freedom
Multiple R-squared:  0.02274,	Adjusted R-squared:  -0.001691
F-statistic: 0.9308 on 1 and 40 DF,  p-value: 0.3405
para el resto. Gráficamente,
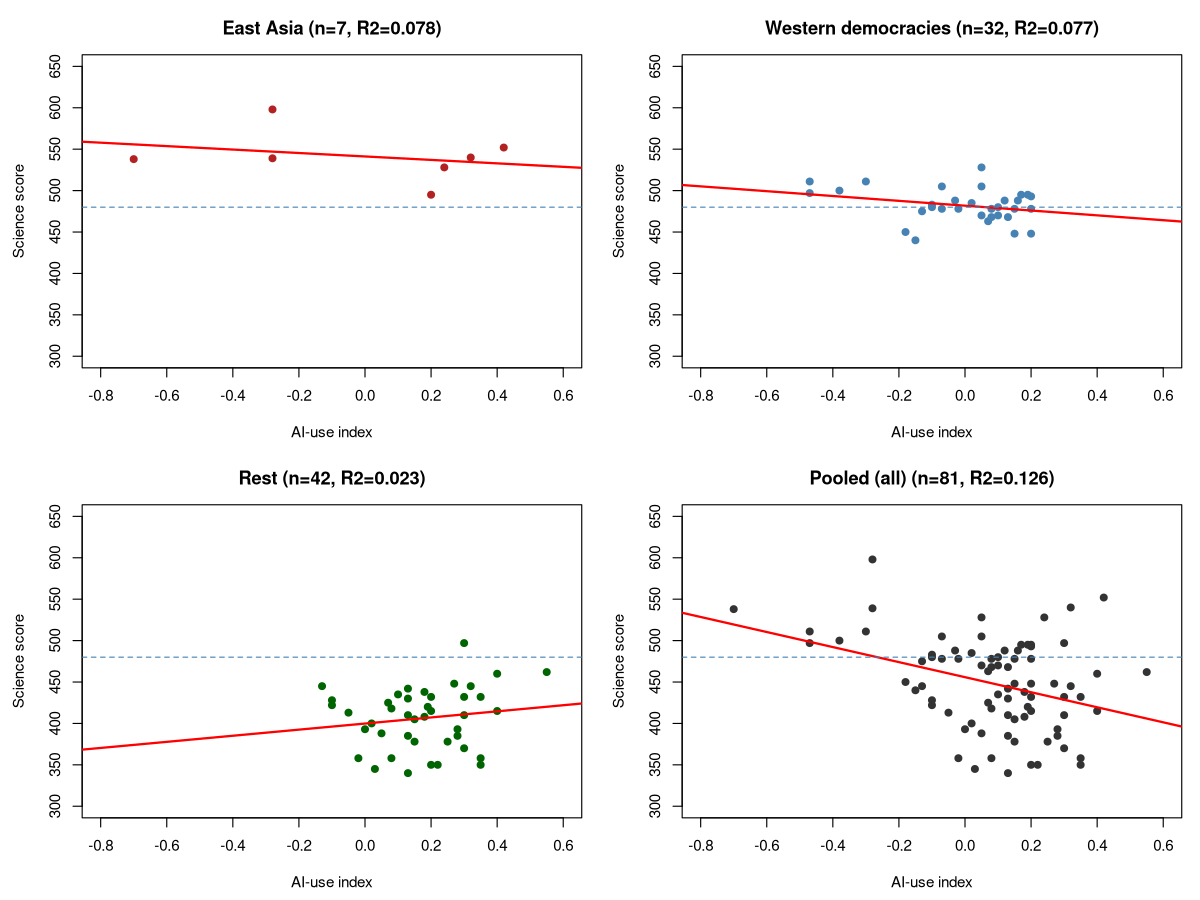
Todavía hay un efecto negativo, pero este parece mucho menos severo y significativo (en una acepción amplia del término).
No sé qué más decir al respecto que no sea invitar a quien haya llegado hasta aquí a visitar (si es que no lo conoce) «Beware of Regional Scatterplots» o la nota que hice sobre dicho artículo en estas páginas.